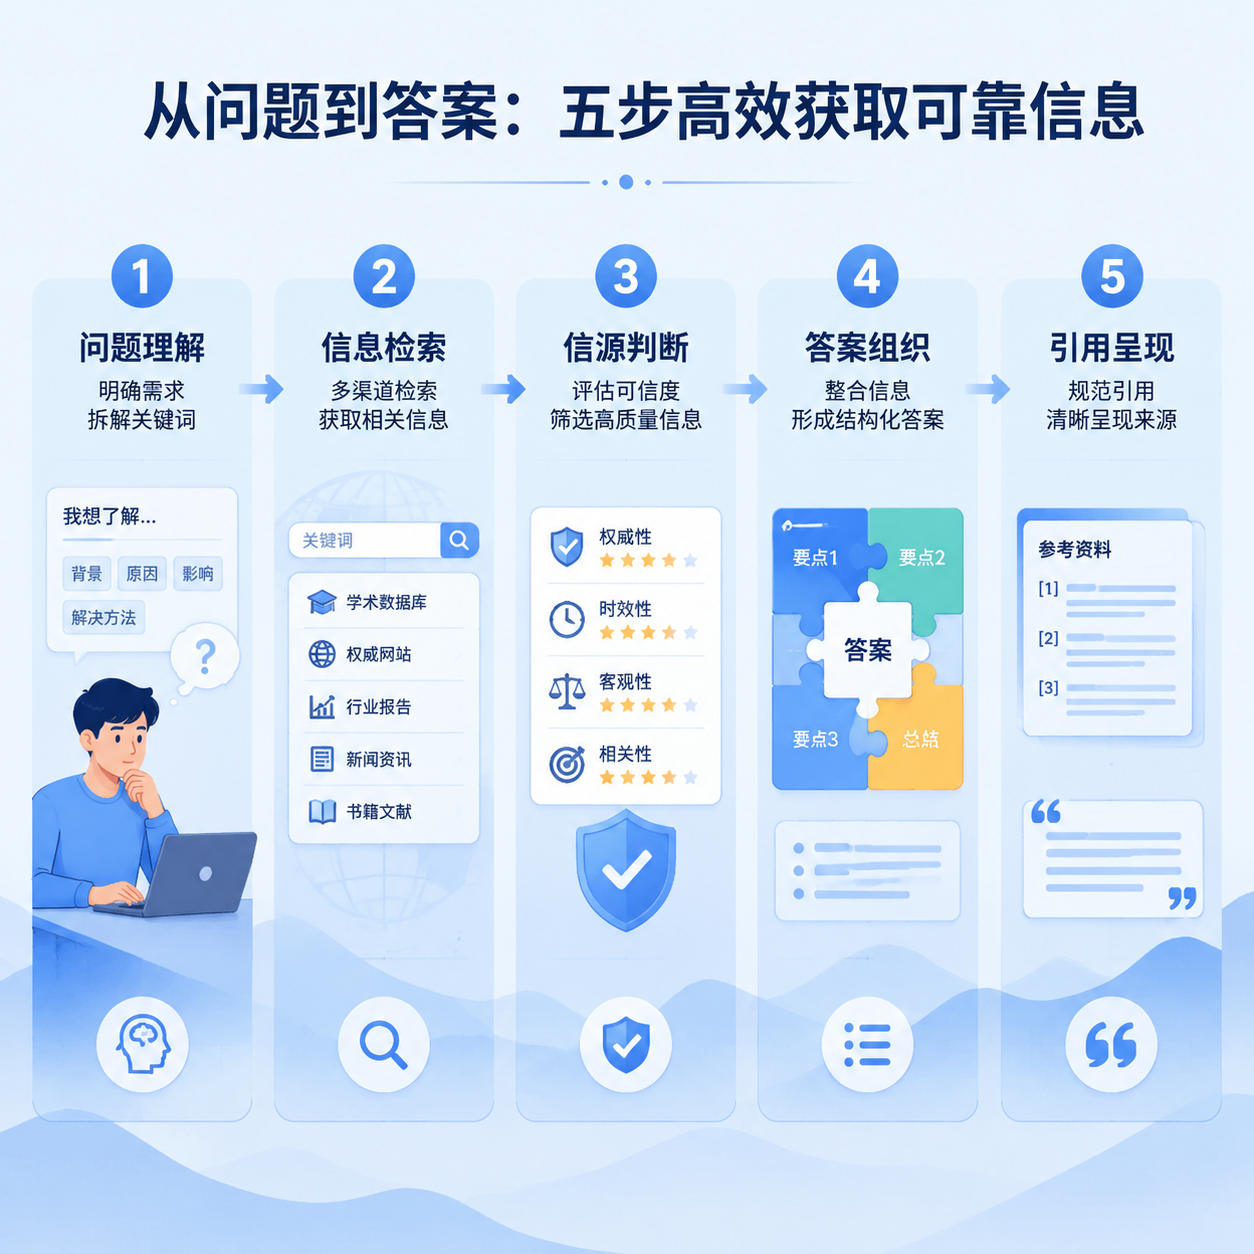
在日常使用豆包AI的过程中,很多用户会好奇:从输入一行提问到收到精准的回答,中间AI系统到底完成了哪些步骤?不同于简单的关键词匹配工具,豆包AI的回答生成是一套经过多层优化的完整链路,每一个环节都直接影响最终输出的准确性、实用性和合规性。
一、用户请求接入与预处理
用户的提问从终端发出后,首先进入链路的第一环节:请求接入与预处理。这一步的核心目标是把用户的原始输入转化为AI系统可以高效处理的标准化信息。
1.1 多模态输入统一解析
当前豆包AI支持文本、图片、语音等多种输入形式,预处理阶段会先完成不同模态信息的统一转换:语音输入会被快速转写为精准文本,图片输入会通过视觉理解模块提取画面中的文字、元素和场景信息,最终所有类型的用户输入都会被整合为结构化的文本请求,传递到下一个环节。
1.2 基础输入清洗
系统会自动过滤输入内容中的无效冗余信息,比如重复的无意义字符、误触产生的乱码内容,同时补全部分用户输入时遗漏的标点符号,避免因为输入格式问题干扰后续的意图判断。
二、用户意图识别与需求理解
完成输入预处理后,链路进入最核心的需求理解环节,这一步直接决定AI能不能准确get到用户的真实诉求,而不是只停留在字面关键词的匹配上。
2.3 多层意图判定机制
豆包AI的意图识别会同时完成三个维度的判定:
- 基础属性判定:明确用户的提问属于知识查询、内容创作、问题解决、闲聊互动等哪一类基础场景
- 深度需求挖掘:识别用户字面提问背后的隐含诉求,比如用户提问「怎么制作活动海报」,系统会进一步判断用户是需要设计思路、工具推荐还是具体的制作步骤
- 约束条件提取:自动抓取用户输入中的限定要求,比如回答的字数、风格、输出格式、特定信息排除规则等
2.2 上下文关联补全
对于多轮对话场景,系统会自动调取之前的对话历史信息,补全当前提问中用户省略的指代内容,避免出现「断章取义」的回答。比如用户先提问「推荐几个北京的咖啡馆」,后续再问「附近的地铁站是哪」,系统会自动关联上一轮的咖啡馆推荐内容,给出对应的交通信息,而不是泛泛解释地铁站的概念。
三、内容生成阶段的核心运行逻辑
当用户的需求被完全结构化解析后,就进入了大家最熟悉的内容生成环节,这也是大模型能力的核心体现部分。
3.1 知识库与能力模块调度
系统会根据识别出的用户意图,自动调度对应的资源库:如果是专业知识类提问,会优先调取经过校验的权威知识库内容;如果是代码开发类需求,会调度对应的代码生成与纠错模块;如果是创意内容类需求,会调用创意生成专属优化路径,确保输出内容匹配对应场景的专业度要求。
3.2 逐Token动态生成优化
豆包AI的回答生成采用逐Token动态预测的机制,每生成一小段内容都会同步校验内容和用户初始需求的匹配度,同时调整后续内容的走向,避免出现内容跑偏、前后逻辑矛盾的问题。生成过程中系统还会自动完成基础的逻辑梳理、语序调整,让最终输出的内容符合人类的日常阅读习惯。
四、多层合规与质量校验环节
为了保障输出内容的安全性、准确性和实用性,豆包AI在内容初步生成完成后,会经过多层独立的校验环节,这也是很多用户看不到但至关重要的链路部分。
4.1 安全合规校验
第一层校验会针对内容的合规性进行全维度扫描,排查是否存在违规、不实、误导性内容,确保所有输出符合相关规范要求,从源头上规避不良信息的流出。
4.2 事实准确性校验
针对知识类、信息类的回答,系统会对内容中的关键事实、数据、常识信息进行二次比对校验,尽可能减少错误信息、过时信息的出现,对于暂时无法确认准确性的内容,会主动标注信息边界,避免误导用户。
4.3 体验优化校验
最后一层校验会从用户体验角度出发,调整回答的结构、排版,补充必要的提示信息,比如对于步骤类内容自动分点梳理,对于复杂概念补充通俗解释,让最终的回答更易读、更易用。
五、最终输出与链路反馈闭环
经过所有校验环节的内容,最终会以适配用户终端的形式输出给用户,而整个链路并不会随着回答发送完成就结束。
系统会自动记录用户后续的交互反馈,比如用户对回答的点赞、点踩,或者针对同一问题的补充提问,这些反馈数据会回流到全链路的各个环节,持续优化意图识别的准确率、内容生成的质量和校验规则的完善度,形成不断迭代的正向闭环。
对于有AI内容生产需求的团队来说,理解豆包AI这类产品的回答生成全链路,也能帮助大家更精准地设置提问指令、明确需求边界,充分发挥AI的内容生产效率优势,结合专业的内容创作工具,搭建属于自己的高效AI内容生产工作流。