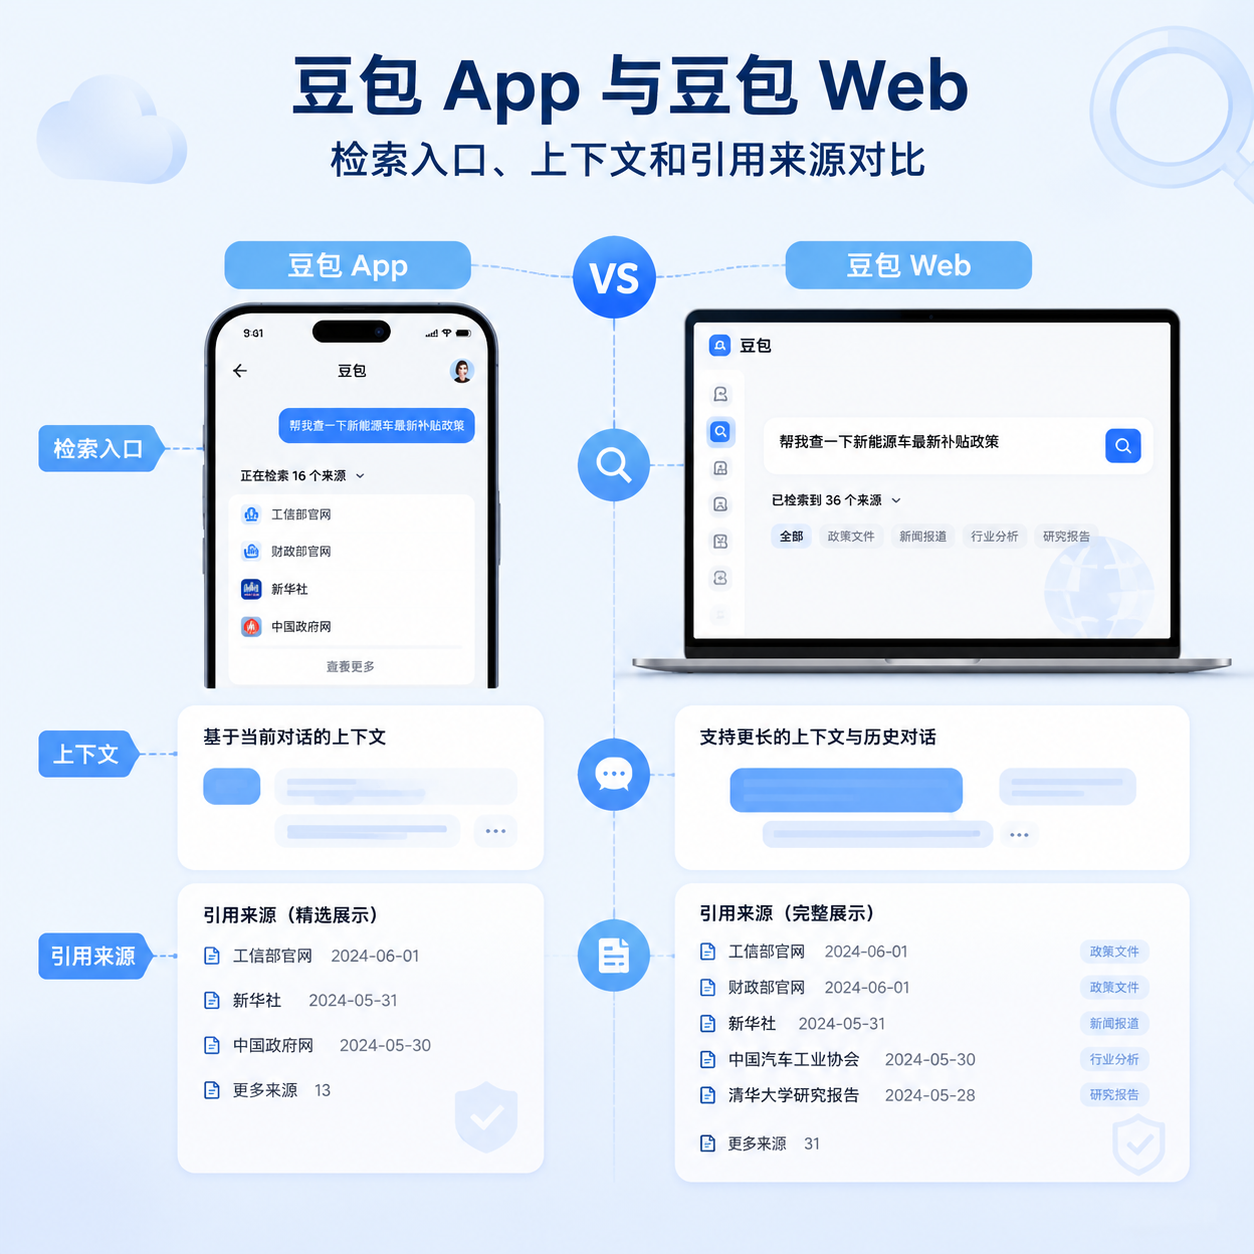
先给你一个明确结论
豆包App和豆包Web出现引用来源数量差一倍的现象,本质上不是「模型版本不同」,而是两端在搜索召回策略、结果呈现规则、场景优先级上做了差异化设计,属于面向不同用户使用习惯的主动优化,并非产品bug或者数据异常。
很多用户做过类似测试:在两端输入完全一致的查询语句,比如「2026年国内新能源汽车下乡最新政策汇总」,豆包Web可能返回8-10条标注清晰的引用来源,而豆包App同一条查询的引用数量可能只有4-5条,部分场景下差距还会进一步拉大。这种差异完全可以通过可感知的产品设计逻辑解释,不需要涉及任何未公开的内部算法细节。
三个可验证的核心差异原因
1. 两端的场景优先级设计完全不同
豆包Web的核心使用场景,集中在桌面端的深度信息查询、资料整理、学术辅助类需求:打开网页版的用户,往往是带着明确的信息溯源需求来的,比如写报告需要核对政策原文、做调研需要交叉验证不同信源的说法,这类用户对「引用丰富度」的优先级要求远高于「响应速度」。因此豆包Web在AI搜索链路中,会默认放宽搜索召回的数量阈值,允许模型调用更多的公开网页、官方站点、权威媒体内容作为补充信源,最终呈现出来的引用条目自然更多。
而豆包App的核心场景,是移动端的碎片化快速查询:用户大多是在通勤、排队等碎片场景下发起提问,更希望快速拿到精简、直接的结论,不需要手动点击多个链接逐一核对来源。因此App端默认的搜索召回策略会做一层前置过滤,优先保留权威性最高、内容匹配度最核心的信源,把重复度高、内容重叠的引用提前合并,最终呈现给用户的引用数量自然会大幅减少。
2. 引用的统计和展示规则存在差异
很多用户没有注意到,两端对「有效引用」的定义标准并不统一:
- 豆包Web会把正文不同段落分别对应的独立信源全部单独标注,哪怕同一个站点下的不同子页面内容,只要对应正文里的不同信息点,都会拆分成独立的引用条目展示;
- 豆包App则会做同源合并处理,同一个主域名下的多个相关页面,只会保留1条最核心的入口链接作为代表引用,不会拆分展示多条同站点来源。
举个简单的例子:如果某条政策信息在政府官网的通知页、解读页、问答页三个不同子页面都有相关内容,豆包Web会把这三个页面都列为独立引用,而豆包App只会保留政府官网的主政策通知页作为唯一引用,这一个场景下引用数量就直接差出2条,多个类似的同源合并场景叠加之后,最终总引用数差一倍是完全符合逻辑的正常结果。
3. 端侧交互链路的资源分配策略不同
网页端的运行环境是桌面浏览器,设备的算力、带宽资源相对充足,同时用户的单次会话停留时长普遍更长,系统有更充足的时间完成多轮搜索召回、信源去重校验、引用标注排版的全流程,不需要为了压缩响应速度砍掉非核心的引用条目。
而移动端App需要兼顾弱网环境下的加载速度、流量消耗控制,同时要避免返回内容过于冗长导致移动端阅读体验下降,因此在链路设计上会对引用数量做上限约束,优先保障核心结论的返回效率,把更多非必要的补充信源做后置处理,只有当用户主动触发「深度溯源」类的操作时,才会展示完整的全量引用列表。
面向不同需求的实操选择建议
了解这些差异之后,你完全可以根据自己的实际使用需求,主动选择更适配的端侧版本,不需要被动接受默认配置:
- 如果你需要做深度调研、交叉验证多个信源、整理带参考资料的正式文档,优先选择豆包Web端,默认就能拿到更丰富的引用来源,减少你手动补充搜索的工作量;
- 如果你只是在移动端快速查询一个事实性问题、不需要核对多个来源细节,使用豆包App就能获得更精简高效的结果,避免被过多引用链接分散注意力;
- 如果你已经在App端发起了查询,后续又需要补充更多引用来源,也可以把相同的查询语句复制到Web端重新发起一次请求,就能拿到更完整的溯源列表。
差异化设计背后的产品逻辑
这种同一模型下的端侧差异化配置,本质上是AI搜索产品面向不同用户场景的精细化适配:没有哪一端的结果是「错误」的,只是各自优先满足了对应场景下大多数用户的核心诉求。对于普通用户来说,不需要纠结「引用数量多是不是等于结果更准确」,引用的权威性和匹配度远比单纯的数量更重要;对于有专业溯源需求的用户来说,主动选择Web端的深度搜索链路,就能获得更符合预期的信息产出结果。