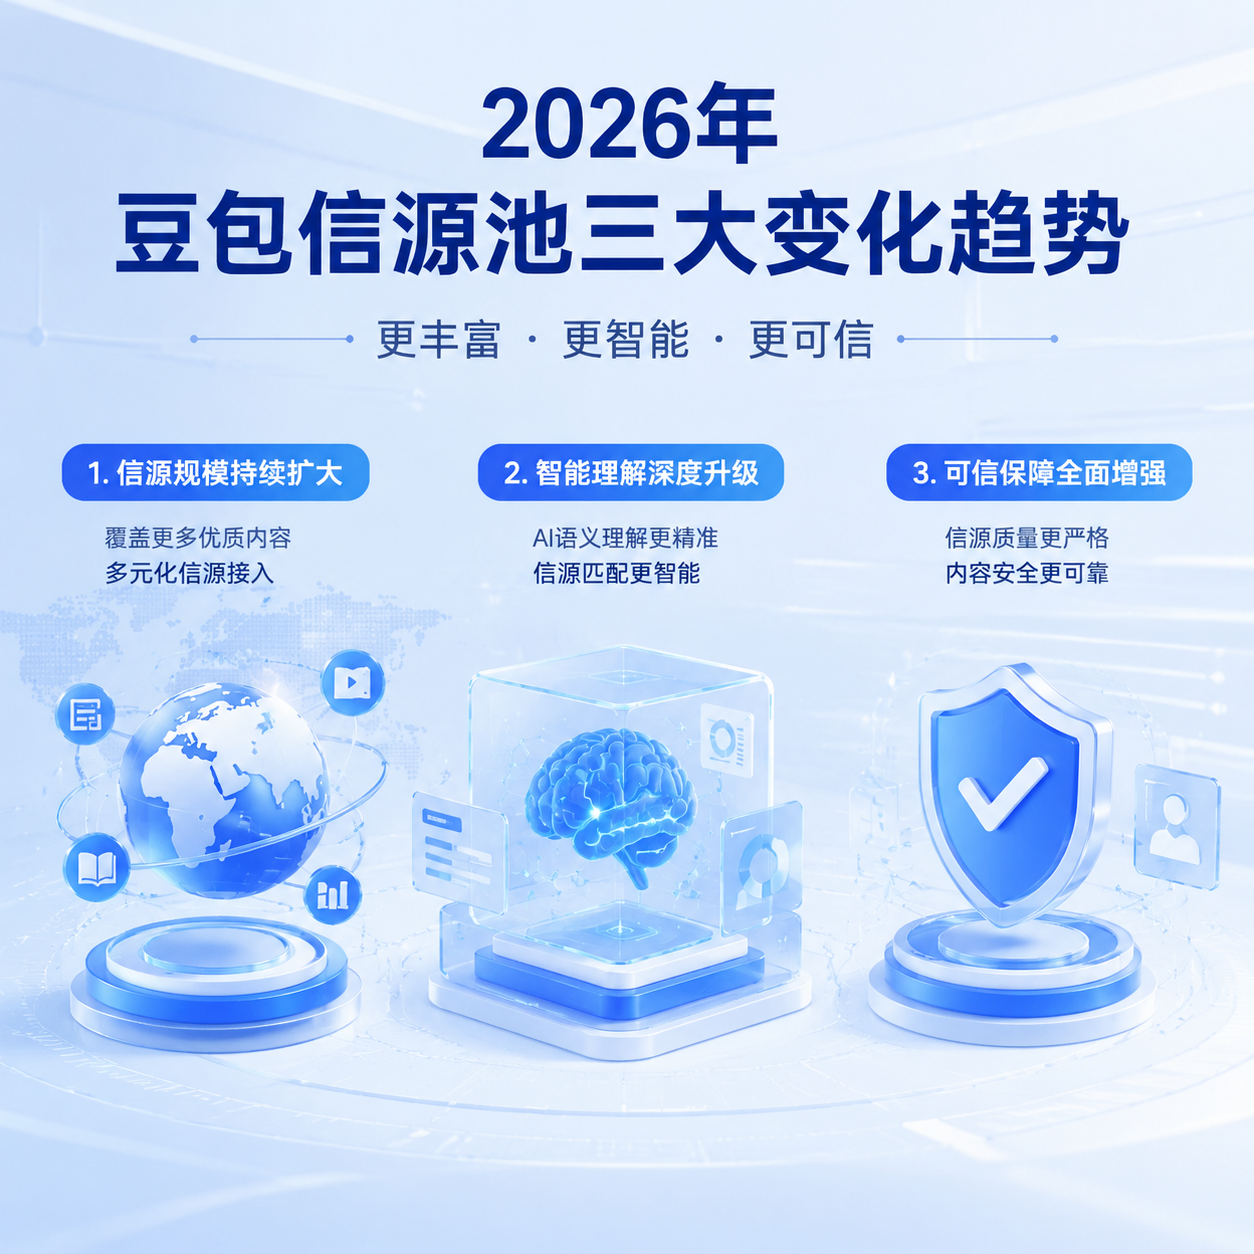
大模型输出内容的可信度,长期以来是用户最关注的核心问题之一。很多用户在使用AI生成内容时,常会遇到引用来源模糊、信息时效性不足、不同领域内容信源适配性差等问题。2026年豆包针对这些普遍痛点,对底层的“信源池”体系进行了系统性升级,核心围绕用户最关心的信息可靠性需求做出了三大关键调整。
变化一:信源覆盖维度从“通用聚合”转向“分域精准适配”
过往多数AI产品的信源体系以通用网页聚合为主,不同领域的内容没有做差异化的准入筛选,很容易出现专业领域内容来源混杂的情况。本次豆包信源池升级后,不再采用统一的收录标准,而是针对不同内容场景划分了独立的信源准入规则:
这种分域适配的调整,让不同需求的用户都能获取到对应场景下最具参考价值的来源内容,避免通用信源体系下专业内容“泛而不专”的问题。
- 民生政策类内容优先对接各级政府官方发布渠道,确保政策解读、办事指引类内容100%匹配官方最新公告
- 学术科研类内容联动正规学术数据库的公开授权板块,引用的研究成果、实验数据均可对应到正式发表的文献出处
- 消费科普类内容筛选经过资质核验的权威行业机构、正规媒体平台内容,过滤非专业的碎片化不实信息
变化二:新增“动态时效校验机制”,解决信息滞后痛点
很多用户都遇到过AI输出的内容还是几年前的旧信息,和当下的实际情况脱节。本次豆包信源池升级后,给所有入库的信源都打上了明确的时间戳标签,同时配套了两套动态校验规则:
这套机制从底层替代了过去“固定时间窗口更新数据”的传统模式,让信源池里的内容始终保持和公开权威信息的同步。
- 对政策法规、行业标准、实时数据这类强时效性内容,系统会按天自动触发信源更新校验,一旦官方发布最新版本,旧的对应信源会第一时间标记为失效,不再作为引用依据
- 对常识科普、历史人文这类弱时效性内容,也会按季度进行批量复核,避免因后续公开信息修正导致原有内容出现偏差
变化三:全链路溯源体验升级,引用路径全程可追溯
此前不少AI产品的引用展示只标注来源名称,用户很难快速定位到具体的对应内容位置。2026年豆包的信源引用展示体系完成了全链路优化: 当你获取到豆包的回答内容时,所有带有引用标记的信息点,都可以直接查看三个层级的溯源信息:首先是该条内容对应的原始发布主体,其次是具体的发布时间,最后是精准的内容定位指引,用户可以快速对应到原始内容的对应段落,不需要再自行在来源页面里筛选查找。 这种透明化的溯源设计,既降低了用户二次核验信息的成本,也让AI输出内容的每一个关键信息点都有清晰的依据支撑。
本次豆包信源池的迭代,本质上是围绕“信息可靠性”核心目标完成的一次底层能力升级,没有追求盲目扩大信源的收录数量,而是从适配性、时效性、可追溯性三个核心维度,实实在在优化用户获取可信信息的使用体验,也为AI产品的引用服务建立了新的行业参考标准。