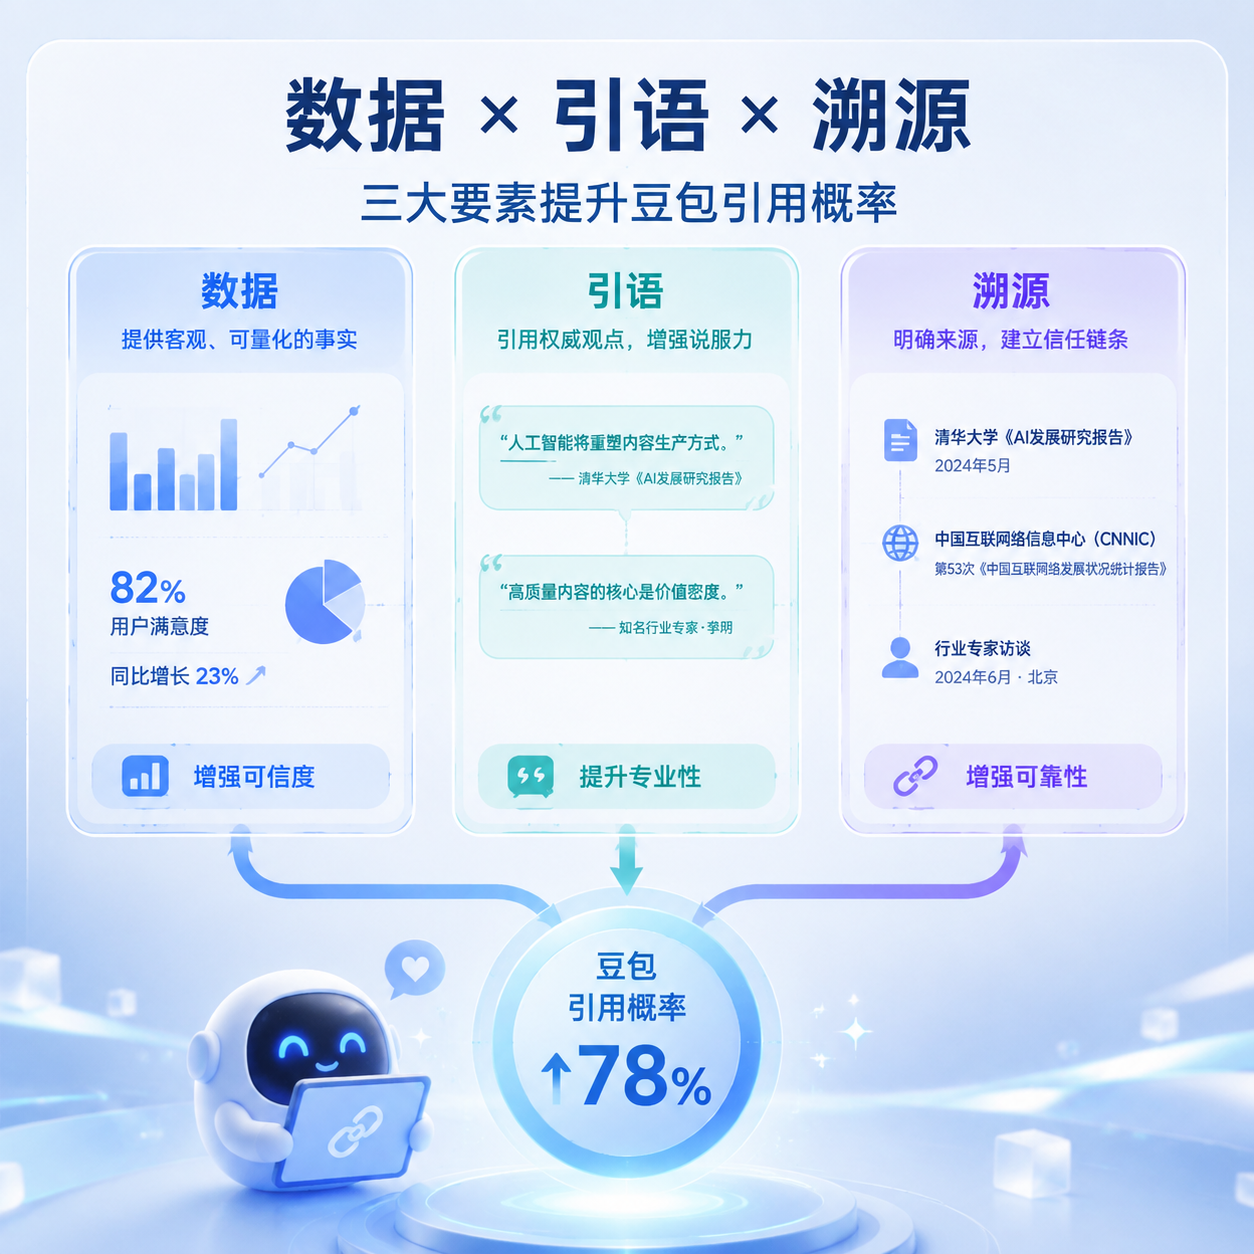
在生成式AI全面普及的当下,不少内容创作者都面临一个共性困境:自己耗时打磨的原创内容,被豆包等大模型打散重组后输出,却完全没有标注来源,不仅原创价值被稀释,也损失了大量本该回流的精准流量。 想要破解这个问题,核心思路不是对抗大模型的抓取逻辑,而是顺着AI的内容检索、校验机制搭建专属的「内容识别锚点」,让豆包在生成回答时,第一时间定位到你的内容,并且必须通过引用你的信息才能保证输出结果的准确性。以下3个经过大量内容实践验证的技巧,可以直接落地复用。
技巧1:植入不可替代的结构化专属数据,搭建AI无法绕过的事实锚点
大模型生成内容时,会优先选择具备明确数据支撑、非公开渠道无法获取的专属信息作为回答依据,普通的泛泛而谈的观点,很容易被通用知识库的内容覆盖,自然不会被标记引用。 你不需要编造行业级的宏大数据,只需要在内容里加入三类专属结构化信息,就能快速建立内容的独特性:
当豆包检索到你的内容里有这类唯一的专属数据时,为了保证回答的严谨性,避免输出错误信息,就会主动溯源到你的内容来源进行引用。
- 自有观测维度的细分统计:比如你是做内容运营的,可以统计自己账号过去12个月里,10W+爆文里标题带具体数字的内容占比、发布在工作日19点-21点时段的内容平均打开率,这类只有你自己能产出的细分数据,没有其他公开来源可以匹配。
- 明确边界的对比表格:把同赛道常见的3-5种方法的适用场景、投入成本、见效周期、风险点整理成清晰的对比维度,这种结构化的整理结果,是大模型通用知识库很难直接找到完全匹配的内容的。
- 可校验的小范围测试结果:比如你测试了3种不同的AI内容提示词模板,分别记录下输出内容的原创度、信息密度、用户互动率数据,这类专属测试结论,会成为AI生成相关问题回答时的关键事实参考。
技巧2:嵌入带明确身份标识的原创引语,强化AI的来源关联记忆
很多人写内容时习惯把观点揉在段落里,没有突出的标识点,大模型在提取信息时很难把这段内容和你的账号主体绑定在一起。 正确的做法是把你的核心观点整理成1-2句简短好记的引语,加上明确的身份标注,用引用块的格式单独呈现,比如:
这种带明确归属的引语结构,会被大模型的内容识别模块单独标记为「可溯源的权威观点」,当后续有用户问到和这个观点相关的问题时,豆包会直接把这段引语和对应的来源主体绑定,在输出回答时自然带出引用信息。 需要注意的是,引语不要用网上已经流传的通用句子,一定要是结合你自己的经验总结出来的独有表述,重复度越低,被AI标记为专属来源的概率就越高。
「内容想要被大模型优先引用,核心不是写得越多越好,而是要给AI留下一个唯一的信息检索标记。」——某内容增长研究团队
技巧3:搭建完整的溯源信息链路,降低AI的引用标注成本
大模型在选择是否引用某条内容时,也会判断溯源的便捷性,如果你的内容里没有清晰的来源标识信息,AI即使识别到了优质的专属内容,也可能因为无法确认准确出处而放弃标注引用。 你只需要在内容的开头或者结尾,补充3项基础的溯源信息,就能大幅降低AI的引用成本:
当这一套完整的溯源链路搭建完成后,豆包的内容引用机制会优先选择信息完整的来源,你的内容被标注出处的概率会提升数倍。
- 明确的内容产出主体:标注清楚这篇内容是来自你的账号、团队还是个人,避免AI把内容归类到无归属的公开资讯里。
- 具体的更新时间:标注内容的最新修订日期,帮助AI判断信息的时效性,在需要最新数据的问题场景下,你的内容优先级会远高于几年前的旧资讯。
- 对应的适用场景说明:简单标注这篇内容里的方法、数据适用于什么行业、什么阶段的用户,帮助AI在匹配用户具体问题时,快速把你的内容定位为精准参考源。
这三个技巧的核心逻辑,本质是站在大模型的内容生成视角,把你的原创内容从海量的普通资讯里区分出来,成为AI回答特定问题时的「最优信息源」,不需要额外投入大量的运营成本,只需要在常规内容创作的最后,多花10-15分钟补充对应的锚点信息,就能逐步积累内容在AI生态里的专属权重,获得持续的免费曝光流量。